- LLM
- Fine-tuning
- LoRA
- QLoRA
- RAG
- Gemma
- Qwen
- Unsloth
- Ollama
- Refauna
Pequenos modelos, conhecimento especializado: fine-tuning e RAG com os dados do Refauna
Como especializei o Gemma 4 E2B e o Qwen3.5-2B com a produção científica do Refauna: preparação dos dados, dataset no formato RAFT, LoRA × QLoRA, avaliação e um RAG offline num MacBook Air de 8 GB.
A pergunta
Dá para pegar um modelo de linguagem de 2 bilhões de parâmetros, rodar num MacBook Air de 8 GB sem internet e fazê-lo responder bem sobre um domínio científico estreito? Em português, citando a fonte e dizendo quando não sabe?
Foi essa a pergunta que levei para o TDC Stage no Rec'n'Play 2026, em Recife. Para respondê-la, especializei dois modelos pequenos e abertos, o Gemma 4 E2B (Google) e o Qwen3.5-2B (Alibaba), com a produção científica do Refauna, combinando fine-tuning e RAG.
A resposta curta: sim, com ressalvas importantes. O RAG trouxe o maior salto de qualidade, o fine-tuning mudou o comportamento do modelo (e não o que ele sabe) e o gargalo final não foi o modelo, foi a busca.
Este post é o relato completo, com foco no que costuma ficar de fora das palestras: a preparação dos dados, o desenho do dataset de treino, a diferença prática entre LoRA e QLoRA e os números de três rodadas de treino avaliadas com o mesmo protocolo. Todo o treino rodou numa GPU NVIDIA L4 no Google Colab, com Unsloth; a inferência roda localmente com Ollama.
O caso e a tese
O Refauna devolve à Mata Atlântica animais que tinham desaparecido localmente, como cutias, bugios, jabutis e antas, para restaurar interações ecológicas como a dispersão de sementes. Desde 2010, o projeto gerou artigos, capítulos, dissertações e resumos em português e inglês. É um domínio estreito, com vocabulário próprio e muitos nomes científicos: um bom teste para um modelo pequeno.
A tese do projeto é que fine-tuning e RAG resolvem metades diferentes do problema:
| Técnica | Resolve | Não resolve |
|---|---|---|
| Fine-tuning (LoRA/QLoRA) | Idioma, estilo, formato, citar fontes, recusar quando não há evidência | Memorizar fatos de forma confiável |
| RAG | Fatos atualizáveis e rastreáveis, sem retreinar | Ensinar um modelo de 2B a usar bem um contexto ruidoso |
Daí vem a decisão central: treinar no mesmo formato que o RAG usa na inferência, no estilo RAFT (Retrieval-Augmented Fine-Tuning). Em vez de ensinar o modelo a responder de memória, eu o ensino a ler trechos numerados, ignorar os irrelevantes, citar [n] e admitir quando a resposta não está lá. Os fatos ficam com o RAG.
Dados, parte 1: abrir os PDFs um por um
Dos 36 PDFs que eu tinha baixado, só 22 tinham o conteúdo esperado. Essa foi a primeira lição, antes de qualquer GPU.
Eu tinha uma planilha com 93 trabalhos do Refauna levantados em repositórios e revistas, e baixei o que estava acessível. Ao comparar o hash e a primeira página de cada arquivo, apareceu isto:
- 9 arquivos eram cópias idênticas de uma dissertação sobre efeito de borda em aves, sem relação com o Refauna. O site devolvia um PDF qualquer no lugar do pedido.
- 2 eram a página de política de privacidade de um site, e 1 era o regulamento de um programa de pós-graduação.
- 2 continham só o título do projeto: um lote de certificados de iniciação científica e uma lista de editais.
- 2 capítulos eram o mesmo livro de 370 páginas (IUCN, Global conservation translocation perspectives: 2021), e um artigo vinha dentro de um boletim inteiro de 70 páginas.
Se eu tivesse treinado direto, o modelo teria aprendido sobre aves de borda de floresta. Os 22 trabalhos válidos ficaram assim: 10 artigos, 4 resumos em anais, 4 iniciações científicas, 2 capítulos, 1 boletim e 1 dissertação.
A solução foi um manifesto, o sources.csv, que virou a fonte da verdade da ingestão. Cada linha diz se o documento entra (incluir_texto), quais páginas usar (paginas, por exemplo 178-182 para recortar um capítulo do livro) e por que foi excluído (observacao). A ingestão ainda tem uma trava por hash de arquivo mais intervalo de páginas, para nenhuma duplicata passar.
for r in manifest:
    if not truthy(r["incluir_texto"]):
        continue
    page_idx = parse_pages(r["paginas"], n_pages)          # "178-182" -> [177..181]
    key = (hashlib.md5(pdf.read_bytes()).hexdigest(), tuple(page_idx))
    if key in seen:
        print(f"{r['doc_id']}: mesmo conteúdo de {seen[key]}, ignorado")
        continue
Os 71 trabalhos sem texto utilizável também não foram descartados: todos os 93 viraram uma ficha de catálogo (título, ano, autores, espécies, local, DOI). As fichas entram no índice de busca, para o assistente responder perguntas como "que estudos o Refauna tem sobre jabutis?", mas não geram exemplos de treino.
Dados, parte 2: três armadilhas na extração de PDF
Extrair texto de artigo científico parece resolvido, até você olhar o resultado. Usei o pymupdf4llm para converter cada página em Markdown e encontrei três problemas silenciosos, todos verificados nos PDFs reais.
1. Duas colunas viravam tabelas. O modo layout da versão 2.x interpretava artigos em duas colunas como tabelas. Num artigo da Elsevier, 89% das linhas saíam como fragmentos de tabela (|palavra|palavra|). Voltar ao modo clássico resolveu:
if hasattr(pymupdf4llm, "use_layout"):
    pymupdf4llm.use_layout(False)
2. Os números sumiam. Esta é a minha favorita. Os artigos da revista Oryx usam algarismos "old-style", que a fonte codifica na área de uso privado do Unicode (U+F730 a U+F739). No terminal eles são invisíveis: "We selected 14 tapirs (7 males, 7 females)" aparecia como "We selected tapirs ( males, females)". Justamente os números, que é o que mais importa num RAG factual. A correção é um mapa de caracteres:
PUA_MAP = {0xF730 + i: str(i) for i in range(10)} | {0xF0B7: "•", 0xF020: " "}
text = text.translate(PUA_MAP)
3. Referências poluíam a busca. Remover a seção "References" pelo título não basta. Em dissertações, cada capítulo tem suas referências; num boletim e num artigo da Frontiers, a lista nem tinha título. A solução foi um detector de densidade: um trecho com 5 ou mais marcas de entrada bibliográfica ("2012. Título.", "7(4): 796", "doi.org/") é descartado.
Com o texto limpo, o chunking divide cada documento por seção e, dentro dela, agrupa parágrafos até ~400 tokens (medidos com o tokenizer do Gemma), com ~60 tokens de sobreposição. Cada trecho guarda documento, seção e páginas, o que permite citar a fonte. Resultado: 374 trechos de texto mais as 93 fichas de catálogo.
Para a busca, indexei os trechos de duas formas: densa, com o EmbeddingGemma 300M no ChromaDB, que entende paráfrases e cruza português com inglês; e léxica, com BM25, que acerta nomes científicos como Dasyprocta leporina, onde a busca vetorial costuma falhar. As duas listas se fundem por Reciprocal Rank Fusion, e os 4 melhores trechos viram o contexto.
O dataset de treino: ensinar a ler, citar e recusar
O dataset final teve 942 exemplos de treino em português, gerados a partir dos trechos e montados em três tipos. A ideia é que cada exemplo tenha exatamente o formato que o modelo vai ver no RAG.
Geração. Para cada trecho com 150 tokens ou mais, o Claude Sonnet 5.5 escreveu 3 pares de pergunta e resposta em JSON, com regras rígidas:
- Gere 3 pares pergunta-resposta que possam ser respondidos SOMENTE com o TRECHO.
- Varie o tipo: factual, conceitual, comparativa, metodologica, didatica.
- Perguntas autocontidas, como um usuário real faria. Nunca "segundo o trecho".
- Respostas com 2 a 6 frases, em PT-BR (mesmo que o trecho esteja em inglês).
- Coloque a marca [FONTE] ao final de cada frase que usa informação do trecho.
- Não invente números, datas ou locais.
A marca [FONTE] é trocada depois pelo número do trecho correto no contexto, o que ensina o modelo a citar [n] no lugar certo.
Montagem. Com as perguntas prontas, cada exemplo vira uma conversa no formato do RAG:
| Tipo | Parte | Contexto | Resposta ensinada |
|---|---|---|---|
rag | ~60% | o trecho certo + 3 distratores vindos da própria busca híbrida, embaralhados | resposta fiel, citando [n] |
unanswerable | ~15% | 4 trechos de outros documentos, fora do top-10 da busca | "Não encontrei essa informação nos documentos do Refauna" |
closed_book | ~25% | nenhum | resposta conceitual, sem números específicos |
Dois detalhes fazem diferença. Os distratores vêm da mesma busca usada na inferência, então o modelo treina com o tipo de ruído que vai encontrar. E os exemplos de abstenção usam trechos de fora do top-10, porque os artigos do Refauna se sobrepõem muito: um trecho "aleatório" do mesmo tema poderia conter a resposta.
Um exemplo no formato de treino, resumido (o trecho [2] é do artigo sobre a reintrodução de antas na REGUA):
system: Você é o Assistente Refauna (...) Quando houver CONTEXTO, use somente as
        informações dele e cite os trechos usados no formato [n]. Se o CONTEXTO não
        contiver a resposta, diga explicitamente que não encontrou essa informação
        nos documentos do Refauna (...)
user:   CONTEXTO:
        [1] (Cid et al., 2014 — Short-Term Success in the Reintroduction...) ...
        [2] (Agles et al., 2025 — Reintroduced tapirs...) ...
        [3] ...
        [4] ...
        PERGUNTA: Quantas antas foram reintroduzidas na Reserva Ecológica de Guapiaçu?
model:  Foram reintroduzidas 14 antas, 7 machos e 7 fêmeas, vindas de seis
        instituições de conservação ex situ [2].
Curadoria. Filtros automáticos removeram respostas fora do português e exemplos rag sem citação; perguntas quase iguais (similaridade de embedding acima de 0,92) foram deduplicadas; e 150 exemplos foram exportados para revisão humana numa planilha.
Split por documento. Cerca de 15% dos documentos ficaram inteiros no teste. Assim a avaliação mede se o sistema traz fatos que o modelo nunca viu no treino, via RAG, e não se ele decorou.
Custo. Somando geração do dataset e o juiz da avaliação, o projeto consumiu cerca de 1,98 milhão de tokens de entrada e 485 mil de saída no Sonnet 5.5, concentrados em dois dias. O modelo grande trabalhou uma vez, na preparação; quem responde no dia a dia é o modelo de 2B, offline.
Fine-tuning, LoRA e QLoRA
Fine-tuning é continuar o treino de um modelo já treinado, com exemplos do seu caso, ajustando os pesos da rede. A questão prática é quais pesos ajustar, porque isso define a memória de GPU necessária.
Fine-tuning completo atualiza todos os bilhões de parâmetros. Além dos pesos, a GPU precisa guardar um gradiente para cada um e os estados do otimizador (o Adam guarda dois valores por parâmetro). Para um modelo de 2B, isso já passa com folga dos 22,5 GB da L4. Não usei.
LoRA (Hu et al., 2021) congela o modelo original e treina, em cada camada escolhida, duas matrizes pequenas cujo produto é somado aos pesos:
W' = W + (α/r) · B · A
com B de tamanho d × r e A de tamanho r × k, r muito menor que d e k
Com rank r = 16, em vez de atualizar uma matriz d × k inteira, treinam-se só r × (d + k) números. No Gemma 4 E2B foram 24,2 milhões de parâmetros treináveis; no Qwen3.5-2B, 10,9 milhões. O resultado é um adaptador de dezenas de MB, que pode ser distribuído sozinho ou mesclado ao modelo.
QLoRA (Dettmers et al., 2023) é o mesmo LoRA, mas com o modelo-base congelado em 4 bits (formato NF4) em vez de 16. Os adaptadores continuam em 16 bits. A promessa é caber modelos maiores na mesma GPU com qualidade próxima à do LoRA.
O custo do QLoRA é tempo: a GPU não multiplica matrizes em 4 bits, então a cada passo de treino os pesos de cada camada são descomprimidos para 16 bits, na ida e na volta. A economia é de memória, não de velocidade.
Uma decisão que não foi minha: a documentação da Unsloth para o Qwen3.5 não recomenda QLoRA para essa família, que tem uma arquitetura híbrida (camadas Gated DeltaNet intercaladas com atenção). Por isso o Qwen foi treinado com LoRA em 16 bits. Para separar o efeito do método do efeito do modelo, treinei o Gemma das duas formas.
Três rodadas de treino, o mesmo protocolo
No Gemma 4 E2B, QLoRA e LoRA deram praticamente a mesma qualidade; o QLoRA economizou só ~15% de memória e foi ~16% mais lento. As três rodadas usaram os mesmos 942 exemplos, os mesmos hiperparâmetros e a mesma GPU (NVIDIA L4, 22,5 GB).
A configuração comum, com Unsloth e TRL:
model, tokenizer = FastModel.from_pretrained(
    "unsloth/gemma-4-E2B-it", max_seq_length=4096,
    load_in_4bit=LOAD_IN_4BIT,          # True = QLoRA | False = LoRA 16-bit
)
model = FastModel.get_peft_model(
    model,
    finetune_vision_layers=False,       # só texto: o E2B é multimodal
    finetune_language_layers=True,
    finetune_attention_modules=True, finetune_mlp_modules=True,
    r=16, lora_alpha=16, lora_dropout=0,
)
# 2 épocas, lr 2e-4 (cosine), warmup 5%, batch 2 x acumulação 4, adamw_8bit,
# avaliação a cada 50 passos e melhor checkpoint por eval_loss
trainer = train_on_responses_only(
    trainer, instruction_part="<|turn>user\n", response_part="<|turn>model\n",
)
O train_on_responses_only é importante: a loss só é calculada sobre a resposta do modelo, e não sobre o system prompt nem os 4 trechos de contexto. O modelo não é treinado para reproduzir os artigos, só para responder sobre eles.
| Rodada | Método | Tempo de treino | Pico de VRAM | Parâmetros treináveis | Melhor eval_loss |
|---|---|---|---|---|---|
| Gemma 4 E2B | QLoRA (base em 4 bits) | 27,8 min | 10,6 GB | 24,2 M | 0,757 |
| Gemma 4 E2B | LoRA (base em 16 bits) | 23,9 min | 12,5 GB | 24,2 M | 0,752 |
| Qwen3.5-2B | LoRA (base em 16 bits) | 14,9 min | 7,9 GB | 10,9 M | 0,769 |
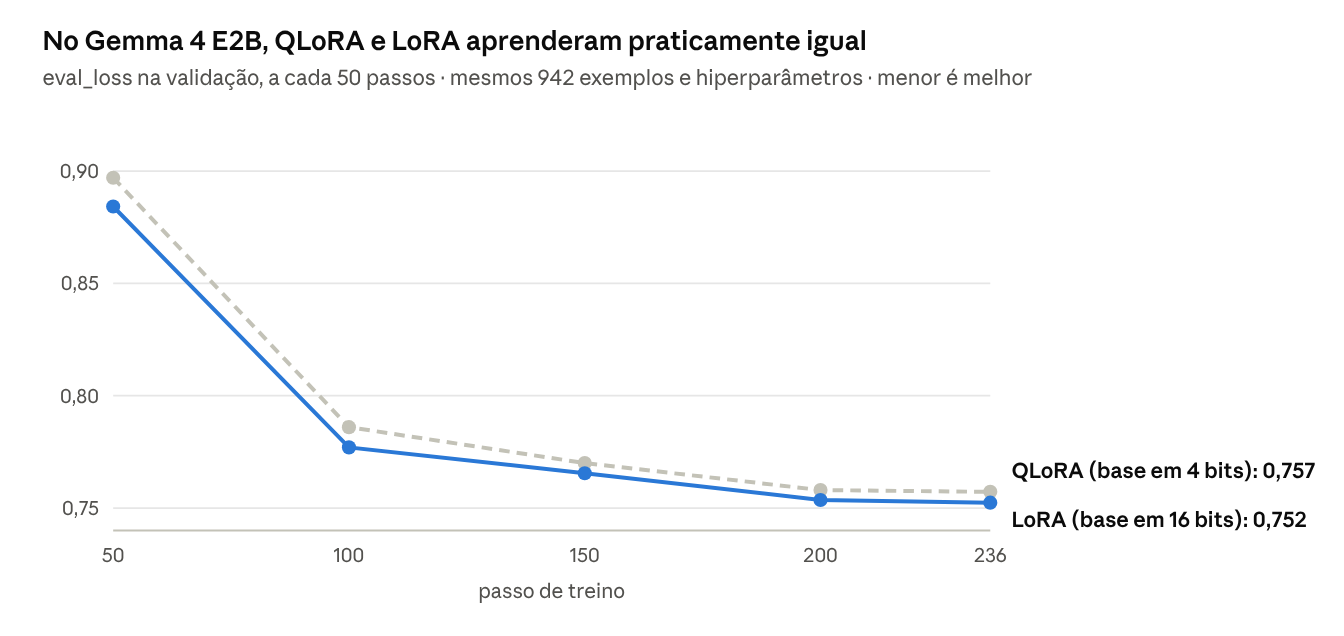
O que a comparação QLoRA × LoRA mostrou no Gemma:
- Qualidade igual. As curvas de
eval_losspraticamente se sobrepõem (0,757 × 0,752 no fim), e as notas de avaliação também empataram (próxima seção). - QLoRA foi mais lento, 27,8 × 23,9 minutos, pelo custo de descomprimir os pesos a cada passo.
- A economia de memória foi pequena: 10,6 × 12,5 GB, cerca de 15%. Num modelo desse tamanho, boa parte da memória de treino vai para as ativações (lotes de sequências de até 4.096 tokens), para os estados do otimizador e para partes do modelo que não são quantizadas, como as camadas de embedding.
Conclusão prática: QLoRA vale quando o modelo não caberia na GPU de outra forma. Num modelo de 2B que já cabe com folga, o LoRA 16 bits foi mais rápido e sem desvantagem.
Dois cuidados de leitura. A eval_loss só é comparável entre as duas rodadas do Gemma; o Qwen usa outro tokenizer, então 0,769 não quer dizer que ele é pior. E no Gemma 4 E2B a loss de treino começa na faixa de 13 a 15, o que a Unsloth documenta como normal para os modelos multimodais dessa família; o que importa é a queda.
O que muda no Qwen. Além do LoRA 16 bits, o Qwen3.5 exige transformers v5 e usa o template ChatML (<|im_start|>user / <|im_start|>assistant). O detalhe mais perigoso: o template do Qwen3.5 liga o modo de raciocínio por padrão, abrindo a resposta com <think>. Treinei e uso sempre com enable_thinking=False, o que faz o template abrir a resposta com um bloco de pensamento vazio, igual no treino e na inferência.
Como avaliei
Cada modelo foi avaliado em quatro configurações, com as mesmas ~60 perguntas de documentos que não estavam no treino:
| sem RAG | com RAG | |
|---|---|---|
| modelo original | A | B |
| modelo ajustado | C | D |
A hipótese era D > B > C > A: a combinação ganharia de tudo. No Colab, não precisei carregar dois modelos para comparar original e ajustado: com o adaptador LoRA, basta desligar o adaptador (with model.disable_adapter():) para obter o modelo original na mesma memória.
As métricas, todas com temperatura 0:
- Correção (1 a 5): um juiz LLM (Claude Sonnet 5.5) compara a resposta com a resposta de referência.
- Fidelidade ao contexto (1 a 5): o mesmo juiz verifica se tudo o que o modelo afirmou está nos trechos recebidos. É a métrica de alucinação.
- Citação correta: automática, verifica se o modelo citou um trecho do documento de origem.
- Abstenção correta: nas perguntas cuja resposta não está no contexto, se o modelo disse que não encontrou. E o inverso, a falsa abstenção: recusar quando a resposta estava lá.
- Idioma e latência: porcentagem de respostas em português e tempo por resposta.
A busca foi medida separadamente: Recall@4 de 0,419 (o trecho de origem aparece entre os 4 recuperados em 42% das perguntas), MRR@20 de 0,296 e 57% das vezes com pelo menos um trecho do documento certo. Guarde esse número: ele explica boa parte dos resultados.
Depois, repeti a avaliação no Mac, com os modelos quantizados (GGUF Q4_K_M) rodando no Ollama, 40 perguntas e métricas automáticas, sem juiz.
Resultados
A hipótese não se confirmou: nas três rodadas a ordem foi B > D > C > A. O maior salto de correção veio do RAG; o fine-tuning mudou o comportamento, não a quantidade de acertos.
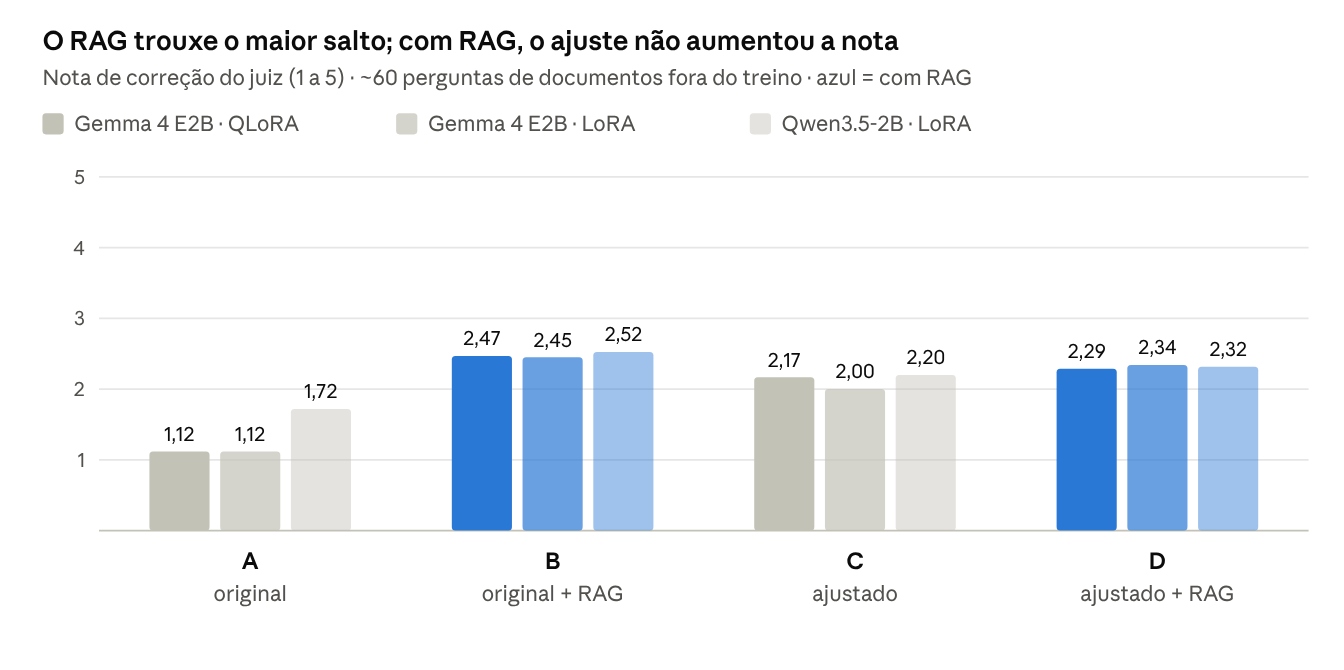
1. O RAG trouxe o maior ganho. Sem RAG, os modelos originais erram quase tudo sobre o Refauna (1,1 no Gemma, 1,7 no Qwen). Com os 4 trechos no contexto, os dois chegam a ~2,5.
2. Com RAG, o fine-tuning não aumentou a correção. D ficou um pouco abaixo de B nas três rodadas, dentro do ruído de ~60 perguntas (diferenças abaixo de 0,2 ponto não significam nada aqui). Sem RAG, o fine-tuning ajuda (C acima de A), mas o modelo continua sem saber os fatos que não viu.
3. O que o fine-tuning mudou foi o comportamento, comparando o modelo original com RAG (B) e o ajustado com RAG (D):
| Rodada | Fidelidade (1–5), B → D | Abstenção correta, B → D | Citação correta, B → D | Palavras por resposta, B → D |
|---|---|---|---|---|
| Qwen3.5-2B · LoRA | 3,17 → 4,41 | 12,5% → 100% | 33% → 45% | 173 → 43 |
| Gemma 4 E2B · QLoRA | 4,35 → 4,17 | 88% → 88% | 52% → 52% | 68 → 44 |
| Gemma 4 E2B · LoRA | 4,34 → 4,21 | 88% → 88% | 52% → 52% | 71 → 42 |
No Qwen, a mudança é grande: o original com RAG inventava além do contexto e quase nunca admitia não saber; o ajustado se abstém sempre que deve e fica fiel aos trechos. O Gemma original já se comportava bem com RAG, então o fine-tuning nele basicamente encurtou as respostas.
A citação correta idêntica (52%) nas variantes do Gemma tem explicação: ela bate no teto da busca. O modelo cita o trecho certo quando ele é recuperado, e a busca só traz o documento certo em cerca de 57% das perguntas.
4. No Mac, offline, o padrão se repete. Com o Qwen ajustado no Ollama, de B para D: citação correta de 17% para 54%, abstenção correta de 12,5% para 100% e respostas de ~270 para ~70 tokens. O custo honesto: a falsa abstenção subiu de 0% para 14% (2 de 14 perguntas em que o trecho certo estava no contexto). O Gemma ajustado teve 58% de citação correta, 75% de abstenção correta e nenhuma falsa abstenção.
5. Gemma × Qwen, com o mesmo método (LoRA 16 bits): empate em correção (2,34 × 2,32 na configuração D). O Qwen ganha em fidelidade, abstenção, velocidade e tamanho; o Gemma cita o trecho certo com mais frequência e não recusa indevidamente. Escolhi o Qwen ajustado como modelo principal da demo.
| No MacBook Air M1, com RAG | Velocidade | Latência mediana | Tamanho do modelo |
|---|---|---|---|
| Qwen3.5-2B · Refauna | 30 tokens/s | 5,7 s | 2,0 GB |
| Gemma 4 E2B · Refauna | 21 tokens/s | 8,6 s | 3,4 GB |
| Qwen3.5-2B original | 22 tokens/s | 19,6 s | 3,1 GB |
O Qwen original não é lento por gerar tokens devagar, e sim por escrever demais: ~330 tokens por resposta contra ~90 do ajustado.
Por que as respostas ficaram 4× mais curtas
O modelo ajustado responde com um quarto das palavras do original, e isso não veio de nenhum parâmetro de "tamanho da resposta". O modelo aprendeu o tamanho pelos exemplos.
- A receita pedia respostas curtas. O prompt de geração do dataset dizia "respostas com 2 a 6 frases, didáticas e fiéis ao trecho". As respostas de abstenção eram uma ou duas frases fixas.
- O fine-tuning imita o estilo dos exemplos. O modelo viu 942 respostas de 40 a 70 palavras, diretas e citando
[n]. Como a loss só é calculada sobre a resposta, tudo o que ele ajustou foi como responder: tamanho, tom, formato e citação. - O modelo original foi treinado para outra coisa: ser um assistente geral de conversa. Esses modelos tendem a escrever bastante, com saudação, listas, títulos e um resumo no final.
O system prompt, a temperatura e o limite de geração foram os mesmos para original e ajustado. A diferença vem só do treino.
Isso trouxe três ganhos: velocidade (menos texto para gerar, de ~17 s para ~6 s no Mac), menos invenção (respostas curtas dão menos espaço para acrescentar o que não está no contexto, o que ajuda a explicar a fidelidade do Qwen subir de 3,2 para 4,4) e formato previsível. O custo é profundidade. Se eu quisesse respostas mais longas e explicativas, o caminho seria mudar a instrução de geração do dataset, por exemplo para "4 a 8 frases, com um exemplo", e treinar de novo.
Do Colab ao MacBook Air de 8 GB
No Mac, o sistema inteiro roda offline: busca híbrida em ~50 a 100 ms, o modelo em GGUF Q4_K_M via Ollama e uma interface em Gradio. O pico de memória do app mais o modelo ficou em 5,7 GB durante 10 perguntas seguidas.
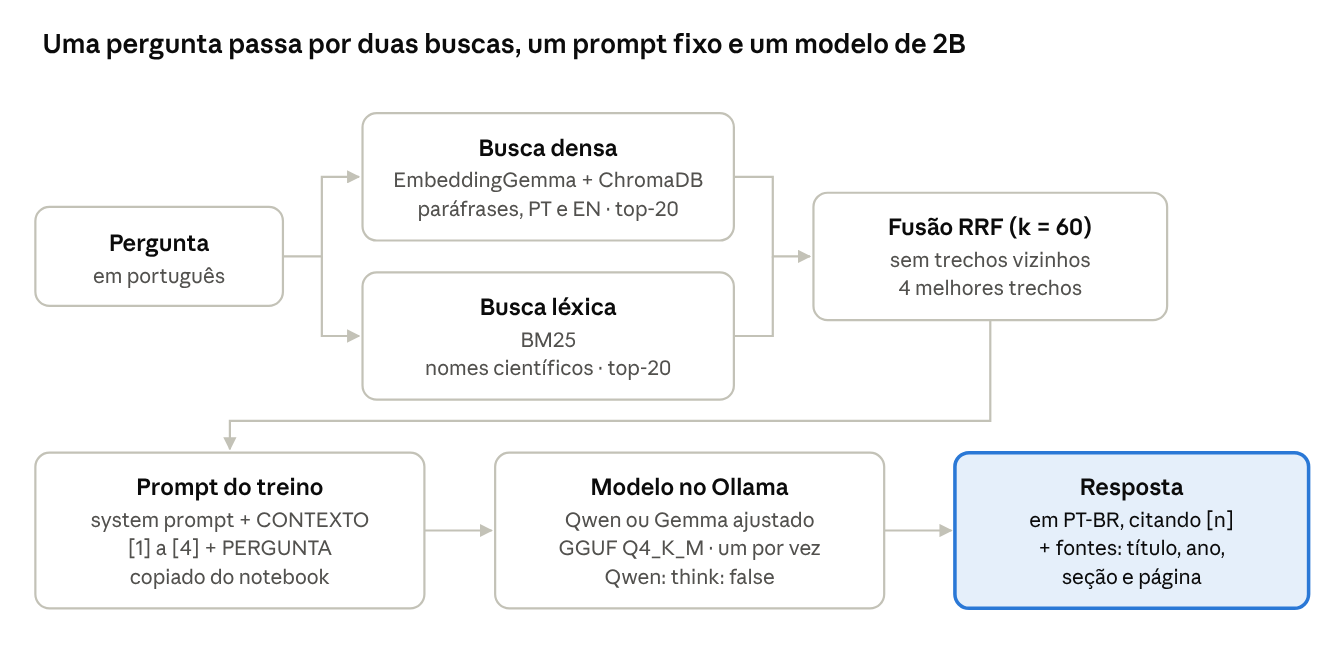
As duas buscas se complementam: a densa entende a pergunta em português sobre um artigo em inglês, e a léxica acerta Alouatta guariba clamitans letra por letra.
Três cuidados fizeram a diferença entre funcionar e funcionar bem.
O prompt de treino é um contrato. Prompt diferente entre treino e inferência é a causa nº 1 de um modelo ajustado "piorar" depois de exportado. Por isso o app local não reescreve nada: o system prompt e as funções que formatam o contexto são copiados da célula do notebook, e um teste automatizado reproduz, caractere por caractere, as mensagens dos 97 exemplos de teste. Um exemplo de quão sutil isso é: no Ollama, enviar think: false para o Gemma mudava 2 tokens do prompt e as respostas divergiam. Sem o parâmetro, ficaram idênticas às do Colab. Já no Qwen, think: false é obrigatório em toda chamada. No teste de paridade com 10 perguntas, cada modelo teve 1 divergência em relação ao Colab, e a busca local reproduziu exatamente o mesmo Recall@4 (0,419).
Em 8 GB, cada gigabyte conta.
- Um modelo por vez. Ao trocar de modelo, o app descarrega o anterior e espera ele sair da memória, porque o descarregamento do Ollama é assíncrono.
- O Gemma original não cabe. A tag padrão do Ollama é uma versão de 7,5 GB que pede 6,9 GiB, e o macOS libera cerca de 4,8 GiB para a GPU. Por isso ele não entrou na avaliação local.
- Tirar o que não se usa. O GGUF do Gemma ajustado carregava um projetor de visão de quase 1 GB que o projeto nunca usa. Numa variante só-texto, o pico da demo caiu de 6,55 para 5,70 GB, com respostas idênticas.
Medir memória do jeito certo. No macOS, o RSS do processo engana: pesos mapeados do disco e buffers da GPU ficam de fora. Em certo momento, o próprio ollama ps mostrou 0,24 GB para um modelo de 3,4 GB. A medida confiável é o footprint do sistema.
Lições aprendidas
- Audite os dados antes de gastar GPU. 14 dos 36 PDFs não eram o que pareciam. Nenhuma técnica de treino compensa um corpus errado, e o problema só aparece abrindo os arquivos.
- Olhe o texto extraído, não só a contagem de caracteres. Tabelas falsas, números invisíveis e listas de referências passam por qualquer verificação automática simples.
- Treine no formato em que o modelo vai ser usado. O RAFT, com distratores vindos da própria busca e exemplos de abstenção, é o que ensinou o modelo a citar e a recusar.
- Fine-tuning ensina comportamento; RAG traz os fatos. Com RAG, o fine-tuning não aumentou a correção, mas mudou fidelidade, abstenção, tamanho e velocidade das respostas.
- Escolha entre LoRA e QLoRA pelo modelo, não por hábito. No Gemma 4 E2B, a qualidade foi a mesma, o QLoRA foi ~16% mais lento e economizou só ~15% de memória. No Qwen3.5, o QLoRA nem é recomendado.
- Trate o prompt de treino como contrato e teste-o. Dois tokens de diferença no prompt já mudam as respostas.
- Meça a busca separadamente: ela é o teto. Com Recall@4 de 0,42, em mais da metade das perguntas o trecho certo nem chega ao modelo, e nenhum modelo acerta o que não recebeu.
- Em hardware pequeno, meça a memória de verdade e corte o que não usa. O projetor de visão sozinho custava quase 1 GB.
Modelos, código e próximos passos
Os modelos estão públicos no Hugging Face, sob licença Apache 2.0, cada um com adaptador LoRA, modelo mesclado e GGUF:
| Modelo | Adaptador LoRA | Modelo mesclado | GGUF (Ollama, llama.cpp) |
|---|---|---|---|
| Qwen3.5-2B · Refauna | qwen3.5-2b-refauna-lora | qwen3.5-2b-refauna | qwen3.5-2b-refauna-GGUF |
| Gemma 4 E2B · Refauna (QLoRA) | gemma-4-e2b-refauna-lora | gemma-4-e2b-refauna | gemma-4-e2b-refauna-GGUF |
Para testar em casa:
ollama run hf.co/iamrodrigocoelho/qwen3.5-2b-refauna-GGUF:Q4_K_M
ollama run hf.co/Refauna/gemma-4-e2b-refauna-GGUF:Q4_K_M
Lembre que os modelos foram treinados para trabalhar com RAG: sozinhos no Ollama, eles respondem bem perguntas conceituais, mas erram fatos específicos dos artigos. No Qwen, envie "think": false nas chamadas à API. Os model cards trazem o formato exato do prompt, a avaliação, as limitações e a lista de fontes com DOI.
O código está em github.com/iamrodrigocoelho/refauna-slm: os notebooks do Colab (preparação dos dados, treino e avaliação de cada rodada) e o app local com RAG offline.
Próximos passos, em ordem de impacto esperado:
- Busca melhor. Um reranker e outra estratégia de chunking atacam o gargalo atual (Recall@4 de 0,42).
- Mais documentos. Há 15 trabalhos já identificados para pedir diretamente aos autores do Refauna.
- Perguntas reais. Um conjunto de avaliação escrito por pesquisadores do projeto, no lugar das perguntas sintéticas.
- Dados abertos. Publicar o dataset de treino e o índice de trechos, com as autorizações dos autores.
Agradeço ao Refauna e a todos os autores dos trabalhos que tornaram este projeto possível.